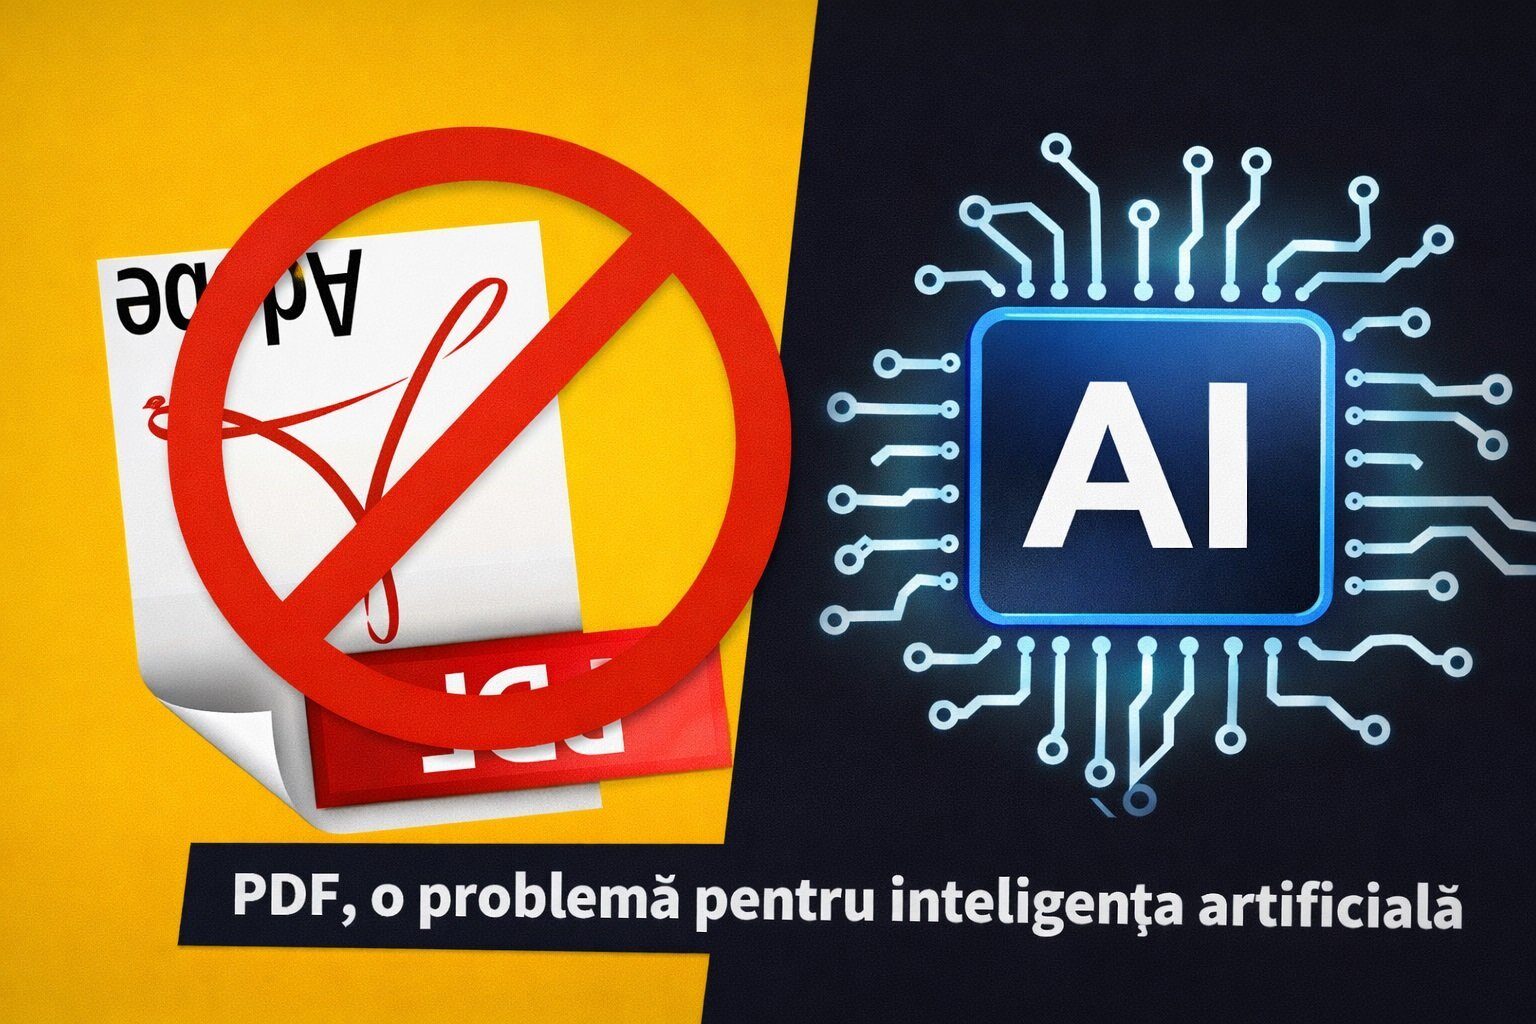
PDF-urile, o barieră în calea inteligenței artificiale
Formatul PDF, standardul omniprezent pentru documente digitale, ridică obstacole semnificative pentru inteligența artificială, îngreunând analiza și interpretarea informațiilor conținute. Deși conceput pentru oameni, PDF-urile pun dificultăți modelelor AI, care se confruntă cu probleme în extragerea și înțelegerea datelor structurate în acest format. Astfel, o cantitate importantă de informație devine inaccesibilă pentru procesare automată, limitând capacitățile sistemelor AI.
Dificultăți în interpretarea structurii documentelor PDF
Creat în 1993 de Adobe, formatul PDF a fost gândit pentru a asigura vizualizarea constantă a documentelor pe orice dispozitiv, indiferent de sistemul de operare. Totuși, structura sa, similară cu o „fotografie” a documentului, prezintă provocări majore pentru AI. Programele trebuie să utilizeze tehnologii de recunoaștere optică a caracterelor (OCR) pentru a transforma imaginile în text digital, proces care funcționează adecvat pentru documente simple. Însă, întâmpină dificultăți majore în cazul fișierelor cu structuri complexe, scanări, scris de mână sau elemente grafice.
Din cauza modului în care sunt construite, modelele de inteligență artificială pot interpreta greșit ordinea informațiilor, mai ales când textul este aranjat în coloane, include grafice sau tabele. Acest lucru conduce la rezultate eronate și la o analiză incompletă a datelor. Pentru comparație, formate precum HTML sunt mult mai ușor de analizat de către AI, datorită etichetelor care indică structura documentului.
Companii în căutarea soluțiilor
Limitările PDF-urilor reprezintă o problemă pentru companiile din domeniul AI. Pe de o parte, utilizatorii se confruntă cu dificultăți în a oferi documente PDF pentru analiză și rezumare. Pe de altă parte, aceste limitări restricționează accesul la un volum important de conținut de calitate, care ar putea fi folosit pentru antrenarea modelelor AI. Estimările arată că între 80% și 90% din datele existente în companii sunt stocate în formate „nestructurate”, inclusiv PDF-uri, înregistrări audio sau video, greu de analizat automat.
Mai multe companii caută soluții pentru această problemă. Startup-ul israelian Factify a atras recent peste 70 de milioane de dolari pentru dezvoltarea unui nou tip de format de document. Scopul este de a păstra avantajele PDF-ului, dar cu o structură mai accesibilă pentru sistemele de inteligență artificială. Totodată, compania europeană Mistral a lansat un sistem OCR bazat pe AI pentru a îmbunătăți citirea documentelor PDF.
În ciuda eforturilor de a îmbunătăți procesarea PDF-urilor de către AI, formatul rămâne dominant. Până în prezent, rezultatele obținute de Mistral nu depășesc semnificativ performanțele tehnologiilor existente, iar piața așteaptă soluții mai eficiente.
Sursa: Mediafax

Articole similare

Fii primul care comentează